Dans notre carrière, on peut être amené à travailler sur des projets qui ont mal vieilli. Parfois le code a plus de dix ans, ce qui est beaucoup pour notre secteur. Pour ma part, j'ai travaillé sur du code qui a été écrit pendant que j'étais au lycée. Cela relativise pas mal cette impression de lire du "mauvais code". En réalité, on lit du code qui a mal vieilli. Au fil des années, les développeurs se sont relayés pour le corriger, le faire évoluer, etc. C'est un code dont on hérite. On parle de Code Legacy. Dans cet article, je vais vous parler de ce code, mais surtout d'une manière de le gérer.
Le code legacy ≠ dette technique 🔗
En introduction, je vous parlais de ce code legacy. C'est le code qui fonctionne en production. Parfois ce code est critique, dans le sens où les fonctionnalités qu'il supporte sont critiques pour le produit. Il peut être incompréhensible, non ou mal testé... Bref, il nous embête ! En revanche, plus il est vieux, plus il a survécu au temps, et donc il n'était sans doute pas de mauvaise qualité à l'époque de son écriture. Je l'ai déjà écrit dans mon scratch il ne faut pas s'attacher à son code : le code de qualité est celui qui reste le plus longtemps correct. Donc ne jugeons pas trop vite du code : regardons déjà quand il a été écrit et surtout s'il nous embête vraiment !
Peut-être avez-vous entendu parler de dette technique. Ce n'est pas tout à fait pareil. Ou plutôt, ce n'est pas aussi simple. C'est Ward Cunningham qui a parlé de dette en premier (pour le Software Engineering)1. La dette technique peut être contractée volontairement par une équipe pour gagner du temps. L'objectif peut être de déployer une nouvelle fonctionnalité à temps, et pour cela on crée de la dette technique. Cette dette devra être remboursée le plus tôt possible2. Si l'équipe ne la rembourse pas, alors cette dette va engendrer des intérêts. C'est-à-dire qu'on va écrire du code qui repose sur cette dette technique, et donc en créer davantage. Avec le temps, cette dette technique deviendra endémique et sera léguée aux futurs devs. Toute la dette technique non remboursée sera héritée, mais tout le code legacy n'est pas une dette.
La tentation serait de tout réécrire, ou de faire une refacto big bang ! C'est une très mauvaise idée, les seniors ou ceux qui ont essayé vous le diront... Alors que fait-on pour gérer la dette technique endémique ?
Gérer la dette technique 🔗
La première chose à se demander sur la dette technique, c'est : est-ce qu'on doit la gérer ? Dans l'absolu, oui, comme décrit dans la partie précédente. On doit rembourser la dette contractée. Mais qu'en est-il de la dette héritée et ancienne ? Eh bien, parfois cela ne vaut pas le coup d'y toucher. Dans un monolithe d'un million de lignes de code, où le legacy est partout, peut-on consacrer les ressources de toute une équipe uniquement à de la refactorisation sur un temps long ? Je dirais que cela dépend. Si l'entreprise n'est plus capable de créer de nouvelles fonctionnalités sur le produit, alors c'est un risque à prendre. Cependant, si on en arrive là, c'est sans doute qu'il est déjà trop tard... Netscape en a probablement fait les frais lorsqu'ils ont voulu réécrire tout le code de zéro : ils ont mis trois ans et, dans le même temps, Internet Explorer a pris possession du marché3.
Refactoring au fil de l'eau 🔗
Admettons qu'on n'en soit pas encore là, mais qu'on ait tout de même des soucis de qualité à gérer dans du code legacy et qu'il soit important. Une technique simple est de réécrire le code "moche" lorsqu'on touche à du code autour. Sonar appelle ça le clean as you code (s'ils n'ont pas repris l'expression ailleurs). Et il est vrai qu'en utilisant Sonar, cette pratique a du sens. En effet, Sonar va lever des code smells (bugs ou mauvaises pratiques) dans le code qu'on aura touché, et ce peu importe si on a touché à la ligne de code en question. C'est vrai que, pendant qu'on est là, on peut corriger les petites erreurs ou mauvaises pratiques.
Cela fonctionne plutôt bien tant qu'on est sur des choses simples et qu'il n'y en a pas beaucoup. Si ma pull request a déjà 50 fichiers changés et +500 -500 lignes modifiées, ajouter de la correction de bugs Sonar va alourdir la revue de code. Dans ces cas-là, on peut faire soit un commit à part, soit une PR dédiée. Maintenant, si la dette technique est un problème d'architecture, ou que le code utilisé est appelé partout, alors c'est plus difficile de le faire au fil de l'eau...
La Pull Request de Refacto 🔗
La dette technique qu'on doit résoudre est trop grosse pour la corriger au fil de l'eau. Il faut faire le changement avant tout nouveau code relatif à cette dette. On va se lancer dans une refacto. On a réussi à convaincre le tech lead ou le product owner qu'une refacto était nécessaire avant de se lancer dans une nouvelle carte, oui on fait de l'agile ici ! On lui a promis que ce serait pas long, 2 ou 3 jours GRAND MAX (tests inclus ?). Souvent, on sous-estime le temps nécessaire pour réaliser une tâche, c'est la loi de Hofstadter. Sauf que dans le cas d'une refacto, c'est d'autant plus vrai et la sous-estimation d'autant plus grande. Parce que du code vieux et mal compris, c'est aussi un code dont on connaît mal les dépendances. Surtout dans le cas de dette d'architecture. Après tout, les développeurs avant nous n'ont pas fait ce code sans raison. Et parfois on découvre un peu tard pourquoi ces choix techniques ont été pris. D'où l'intérêt des ADR (Architecture Decision Records), dont on parlera un jour.
Il m'est arrivé de me lancer dans une refacto qui devait prendre une semaine et qui en a duré trois. Enfin, je ne l'ai jamais finie : j'ai fini par abandonner vu le temps que j'avais passé dessus et ce qu'il restait à faire... C'est presque un rite initiatique : tout dev aura envie un jour de faire cette refacto, et il n'entendra pas les expérimentés le lui déconseiller. Comme s'il fallait absolument le vivre pour le comprendre.
Alors, toutes les refactos ne finissent pas tragiquement, c'est l'expérience qui nous apprend à reconnaître les pièges. Ce que je fais aujourd'hui, c'est définir un cadre de temps fixe maximum après lequel je fais le point, de préférence avec l'équipe, pour voir si on veut continuer ou arrêter les frais. En général, c'est 1 ou 2 jours de timebox.
Résumons donc un peu la réflexion que je donne jusque-là sur la gestion du code legacy :
- ne rien faire
- surtout ne pas repartir de zéro
- faire au fil de l'eau pour les petits bugs
- si c'est un peu plus gros, faire des commits séparés ou une Pull Request à part
- y consacrer du temps mais pas trop !
Et on fait quoi si on doit gérer le problème et que c'est trop gros pour une refacto de quelques jours ?
Strangler Fig 🔗
Une première chose à faire si on est confronté à du gros code legacy, c'est de le cacher ! On va utiliser le Facade Pattern pour cacher tout le code moche derrière du code plus joli. Alors, on ne résout pas vraiment le problème, mais cela a au moins le mérite de faire en sorte que le code à refactorer ne soit plus utilisé directement. On évite de propager le problème et de rendre la refacto de plus en plus compliquée avec le temps. En Java, on peut aussi ajouter une annotation @Deprecated pour marquer une méthode (voire toute une classe) comme obsolète. Le code ainsi marqué permet d'indiquer à tous les développeurs qu'il ne faut plus l'utiliser. Tout le monde n'est pas forcément au courant que le code dans une méthode est obsolète, problématique ou en cours de migration. Couplé à du sonar ou des ArchUnit tests, on peut interdire automatiquement toute nouvelle utilisation des méthodes dépréciées.
Cette tactique ne sert pas qu'à cacher du code legacy. C'est l'étape préparatoire au pattern de refacto dont on va parler ici : le Strangler Fig Pattern. Le nom vient de Martin Fowler4 et il y décrit cette analogie avec le figuier étrangleur. L'idée est qu'on va construire sur les bases existantes le nouveau code pour le remplacer petit à petit. Techniquement, cela consiste à :
- Ajouter un proxy qui va intercepter toutes les requêtes vers le système à remplacer avant de les lui envoyer. On ajoute une couche "passe-plat" pour le moment (2).
- Ensuite on va écrire le nouveau système en reprenant une fonctionnalité, et une seule, de l'ancien système. Une fois qu'il est prêt, on redirige les requêtes de cette fonctionnalité vers le nouveau système tandis que les autres pointent toujours vers l'ancien (3).
- Et on itère sur les autres fonctionnalités petit à petit. Une fois que toutes les fonctionnalités auront été migrées, on va pouvoir supprimer l'ancien système puis le proxy pour ne laisser plus que le nouveau système (4).
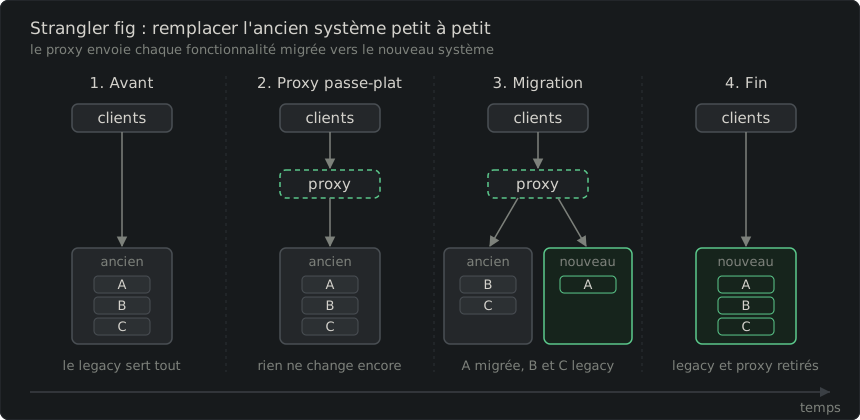
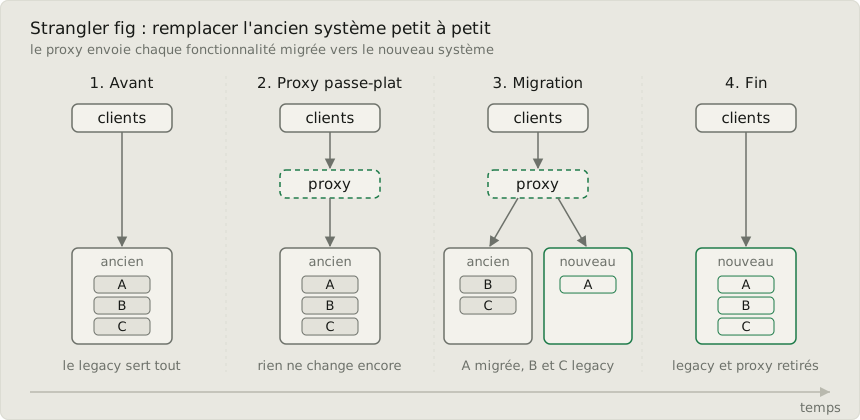
Conçue pour gérer le remplacement d'un système complet, cette méthode peut aussi s'adapter au code. Par exemple en Java, la création du "proxy" revient à créer un service par lequel le code devra passer pour appeler la fonctionnalité. La façade dont je parlais au début en est un. Cette déclinaison à l'intérieur du code porte d'ailleurs un nom : la Branch by Abstraction5. D'où le nom du projet exemple que j'ai créé, avec l'aide d'un LLM, et que vous pouvez trouver ici : Yagni/strangler-by-abstraction
La première étape, créer la façade, est réalisée dans ce commit
. Je crée donc un record purement métier Loan dans le package loan, qui correspond au "nouveau système". Il reprend quasiment à l'identique la classe Loan du package legacy. Ce projet n'étant qu'un exemple, j'ai préféré rester simple dans la nouvelle version de Loan, même si j'aurais sans doute dû créer plus de value objects, mais c'est du détail. J'ai également créé une nouvelle version de LoanException, mais surtout j'ai créé la façade LoanService. C'est elle qui va appeler le legacy :
@Service
public class LoanService {

    private final LoanManager legacy;

    public LoanService(LoanManager legacy) {
        this.legacy = legacy;
    }

    @Transactional
    public Loan borrow(long memberId, long bookId) {
        try {
            return translate(legacy.borrow(memberId, bookId));
        } catch (fr.yagni.strangler.legacy.LoanException e) {
            throw translate(e);
        }
    }

    public List<Loan> getCurrentLoans(long memberId) {
        return legacy.getCurrentLoans(memberId).stream()
                .map(LoanService::translate)
                .toList();
    }

    // renew, returnBook, getOverdueLoans, isAvailable : même principe

    private static LoanException translate(fr.yagni.strangler.legacy.LoanException legacy) {
        return new LoanException(Reason.valueOf(legacy.getCode()), legacy.getMessage(), legacy);
    }

    private static Loan translate(fr.yagni.strangler.legacy.Loan legacy) {
        return new Loan(new Loan.Id(legacy.getId()), legacy.getMemberId(), /* … */ legacy.getFee());
    }
}
Ce que fait ce nouveau service, c'est injecter le service legacy LoanManager et l'utiliser dans toutes les méthodes où c'est nécessaire. Il faut également ajouter des tests sur toutes les méthodes utilisées. L'objectif est de vérifier à chaque étape que les tests passent encore.
Dans un autre commit
, je remplace donc tous les appels à LoanManager par des appels à LoanService. J'en profite pour marquer LoanManager comme @Deprecated, pour éviter qu'un autre développeur n'ajoute d'utilisation du legacy. Le proxy est en place !
On peut maintenant écrire le nouveau système dans le package loan, notamment LoanRepository, et l'utiliser dans la façade. Il va renvoyer le record Loan plutôt que la classe du legacy, et pour cela je fais une méthode de traduction. Je commence par migrer une méthode simple dans un premier commit
, puis j'enchaîne dans un second
avec une méthode plus complexe, avec de la logique métier, mais surtout la suppression de code dans la partie legacy. C'était du code qui n'était plus utilisé : on a migré du legacy vers du moderne !
@Service
@SuppressWarnings("deprecation")
public class LoanService {
    private final LoanManager legacy;
    private final LoanRepository repository;
    private final Clock clock;
    // constructeur…

    @Transactional
    public Loan borrow(long memberId, long bookId) {
        Member member = repository.findMember(memberId)
                .orElseThrow(() -> new LoanException(Reason.MEMBER_NOT_FOUND, "Member " + memberId + " not found"));
        LocalDate today = LocalDate.now(clock);
        if (member.membershipEndedBefore(today)) {
            throw new LoanException(Reason.MEMBERSHIP_EXPIRED, "Membership of member " + memberId + " has expired");
        }
        // … livre existant et disponible, pas de retard, pas d'impayés, quota
        Loan.Id id = repository.insertLoan(memberId, bookId, today, today.plusDays(LOAN_DAYS));
        return repository.findLoan(id).orElseThrow();
    }

    @Transactional
    public Loan renew(long loanId) {
        try { return translate(legacy.renew(loanId)); }
        catch (fr.yagni.strangler.legacy.LoanException e) { throw translate(e); }
    }

    public boolean isAvailable(long bookId) {
        return !repository.hasOpenLoan(bookId);
    }

    // returnBook, getCurrentLoans, getOverdueLoans : encore délégués au legacy
}
L'exemple ne termine pas la migration, ce n'est qu'un exemple, mais y compris en conditions réelles, rien ne dit qu'on finira la migration en un seul sprint ou dans un temps court ! Peut-être que cette migration se fera en parallèle de l'ajout de fonctionnalités et qu'on n'y consacrera qu'une petite bande passante.
Conclusion 🔗
Cette méthode de refactorisation permet de migrer du vieux code vers du nouveau tout en permettant l'ajout de fonctionnalités sans attendre trois ans. L'important est de s'assurer que plus personne n'appelle en direct l'ancien code et que tout passe par la façade. Pour les toutes petites refactos, ce n'est pas nécessaire, mais pour celles qui sont plus conséquentes, cela fonctionne bien.
En revanche, ce que cette méthode ne permet pas ou ne résout pas complètement, ce sont les problématiques de cohabitation. Parfois, on ne peut pas migrer petit bout par petit bout. Par exemple, si les actions de lecture peuvent être migrées facilement, pour les actions d'écriture ce n'est pas toujours le cas.
Ce n'est pas parce que cette méthode permet de migrer le code en prenant son temps qu'il faut faire durer la cohabitation ! L'objectif reste de se séparer du vieux code et le plus tôt sera le mieux. Si on veut le décommissionner, c'est pas pour rien, donc on ne gagne rien à le laisser là. Cette méthode permet juste de le faire par étapes sans tout casser. L'ajout d'une façade et les traductions entre l'ancien et le nouveau code sont eux-mêmes de la dette technique volontaire : elle doit être temporaire et remboursée. Sinon, la méthode ne règle pas le problème qu'elle est censée résoudre.
-
Ward Cunningham, The WyCash Portfolio Management System, rapport d'expérience présenté à OOPSLA en 1992. ↩
-
Ward Cunningham, Debt Metaphor, vidéo de 2009 où il revient sur la métaphore de la dette. ↩
-
Joel Spolsky, Things You Should Never Do, Part I, post de blog en 2000. ↩
-
Martin Fowler, Strangler Fig, 2004, réécrit en 2024 (en anglais). ↩
-
Martin Fowler, Branch By Abstraction, 2014, d'après la technique de Paul Hammant (en anglais). ↩