Je pense qu'on connait tous ce qu'est la Backward Compatibility. Quand on fait des api REST c'est quelque chose qu'on entend souvent. Faire des api compatibles avec le passé, c'est bien ancré dans nos têtes. En revanche, faire des api compatibles avec le futur, rarement. La Forward Compatibility c'est produire du code capable de résister au futur. Je vais détailler ici ce que je connais du sujet, comment j'y ai été confronté et ce qu'il est possible de faire.
Mise en situation
J'ai été amené dans mon parcours professionnel à créer tout un système de webhooks. Jusqu'à présent le produit n'avait que des api REST, ce qui est bien pratique mais pas suffisant notamment pour les cas où le client (enfin son SI) souhaite savoir quand un objet est supprimé par exemple. Sans entrer trop dans les détails, l'infra des webhooks consiste en plusieurs instances d'une même application déployée dans un cluster kubernetes. C'est résilient, on peut faire des déploiements sans interruption de service. Bref c'est le FUTUR, ou le passé si vous me lisez depuis le futur...
Les autres applications vont envoyer des évènements aux webhooks et le message sera distribué à une seule des instances. Si on schématise ça donnerait quelque chose comme ceci:
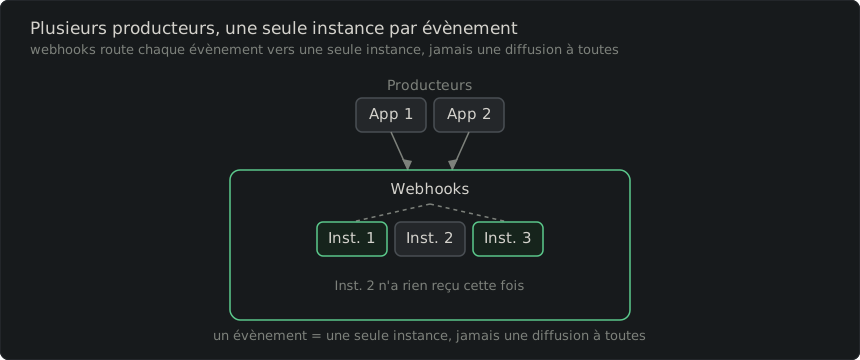
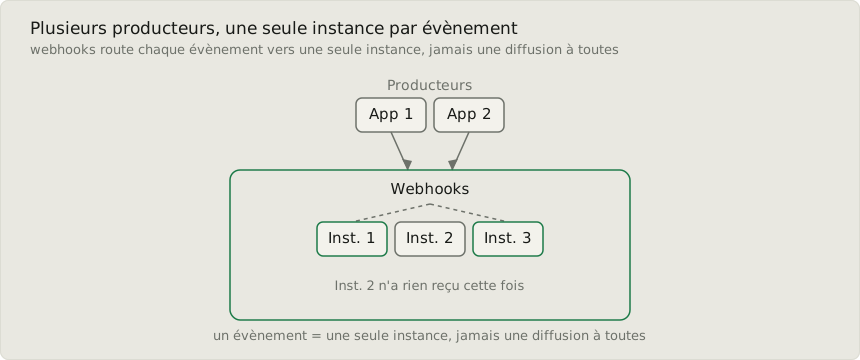
On va garder cet exemple des webhooks tout le long de l'article pour illustrer et mieux comprendre ce dont on va parler. Pimentons un peu cette histoire avec une évolution dans les évènements:
- v1: état initial, un seul évènement
ORDER_CREATEDavec les deux champsamountetorderId. - v2: ajout du champ
currency. - v3: nouvel évènement
ORDER_REFUNDED - v4: renommage du champ
orderIdenid
Backward compatible
Le backward compatible, comme je le disais en introduction, on le connait bien. Même si on ne fait pas d'api REST, on le rencontre assez rapidement sur d'autres sujets, notamment avec les base de données. Supprimer une colonne dans une table est un breaking change. Si on ne déploie pas dans le même temps une nouvelle version de l'applicatif qui n'utilise plus cette colonne, on va avoir des erreurs! Même sanction si on renomme un champ. Habituellement ce qu'on fait c'est qu'on fait des petites versions itératives pour éviter le souci. Prenons l'exemple d'un renommage de colonne, de nom vers full_name : ça donnerait quelque chose comme ceci, étalé sur quatre petites versions :
| Version | Application | Base de données |
|---|---|---|
| v1.0 | lit et écrit nom | colonne nom |
| v1.1 | lit nom, écrit nom et full_name | + colonne full_name |
| v1.2 | lit et écrit full_name (n'utilise plus nom) | nom et full_name (mais nom n'est plus lu) |
| v2.0 | lit et écrit full_name | colonne nom supprimée |
Chaque étape mineure permet de s'assurer qu'on n'aura pas de soucis de version entre l'application et la base de données. C'est un classique de migration. Même dans le cas où on aurait plusieurs instances de l'application, ces déploiements par étapes mineures permettent d'éviter toute erreur.
Si on reprend notre exemple des webhooks et de l'évolution des évènements, la v2 ajoute un champ, ce n'est pas un breaking change en théorie. Il faut juste faire attention à la modélisation pour s'assurer que la lecture de l'évènement ne tombe pas en erreur. En Java, avec Jackson, par défaut si un champ présent dans le JSON ne l'est pas dans le modèle, on aura une erreur. Deux options: soit on change ce comportement, soit on modélise de façon à ce que l'ajout d'un champ ne soit pas un breaking change. Alors évidemment on peut faire les deux, protocole bretelle-ceinture!
Ce qu'on peut faire donc c'est éviter ce type de modélisation:
{
  "eventType": "ORDER_CREATED",
  "id": "v1-order-1",
  "occurredAt": "2026-01-01T10:00:00Z",
  "orderId": "ord-1",
  "amount": 42.50
}
Il y a trois soucis avec ce modèle:
- tout ajout de champ provoque une erreur si on a le comportement par défaut de Jackson
- toute suppression de champ provoquera une erreur
- si on a plusieurs évènements il faudra soit plusieurs endpoints (si on fait du REST), soit gérer intelligemment la sérialisation
Le plus simple est d'adopter une modélisation de ce type:
{
  "eventType": "ORDER_CREATED",
  "id": "v1-order-1",
  "occurredAt": "2026-01-01T10:00:00Z",
  "data": {
    "orderId": "ord-1",
    "amount": 42.50
  }
}
Avec cette modélisation, on sépare les métadonnées des données et on peut donc gérer aussi bien les changements de modèle que plusieurs évènements! Le champ eventType permet de savoir ce qu'on aura dans data.
On pourra même ajouter un champ version pour lire plusieurs versions d'un même évènement dans le même code, avec ou sans breaking changes.
Et en Java on aurait ceci:
@JsonIgnoreProperties(ignoreUnknown = true)
public record EventEnvelope(
        String version,
        EventType eventType,
        String id,
        Instant occurredAt,
        Map<String, Object> data
) {
}
Ok donc en modélisant intelligemment, ajouter un champ ne casse rien. Pour être backward compatible, il faut donc que le code lié à la v2 dans les webhooks lise les champs v1 et ne plante pas s'il y a des champs v2 absents. Ça donnerait quelque chose comme ça:
    private void handleOrderCreated(EventEnvelope envelope) {
        Object orderId = envelope.data().get("orderId");
        if (orderId == null) {
            throw new MissingRequiredFieldException("orderId", envelope.id(), envelope.eventType().name());
        }
        Object amount = envelope.data().get("amount");
        if (amount == null) {
            throw new MissingRequiredFieldException("amount", envelope.id(), envelope.eventType().name());
        }

        Object currency = envelope.data().getOrDefault("currency", "EUR");

        log.info("Order {} created, amount={} {}", orderId, amount, currency);
    }
Ainsi, avec du v1, on aura Order ord-1 created, amount=42.5 EUR et avec du v2 Order ord-1 created, amount=42.5 USD par exemple. On aurait également pu, à la place d'avoir une valeur par défaut, ne rien afficher.
Alors pour l'ajout de champ ça fonctionne, cependant que se passe-t-il si on a nos webhooks en v1 et les producteurs d'évènements passent en v2? Sans l'annotation Jackson @JsonIgnoreProperties(ignoreUnknown = true), des erreurs. Avec, pas d'erreur, mais c'est uniquement parce que ce n'est pas un vrai breaking change. Si nos producteurs passaient directement en v4 (le renommage de orderId en id), ce serait la catastrophe... Il faut donc faire une migration coordonnée. On migre d'abord toutes les instances de webhooks pour être en v4 (gérer donc l'ancien et le nouveau nom de champ) puis seulement on migre les producteurs pour qu'ils puissent envoyer du v4. Cela ressemble un peu aux migrations itératives présentées précédemment.
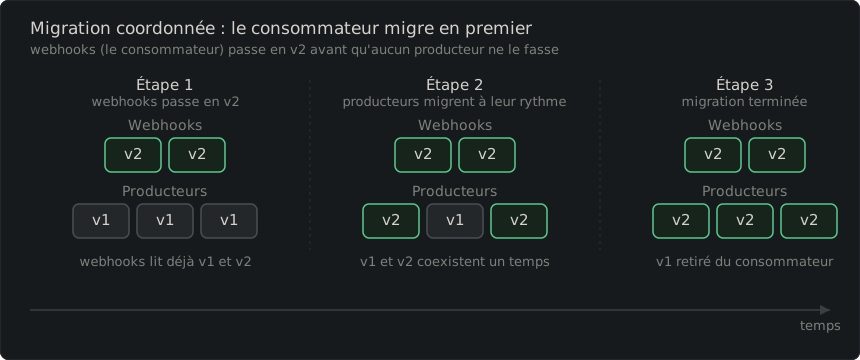
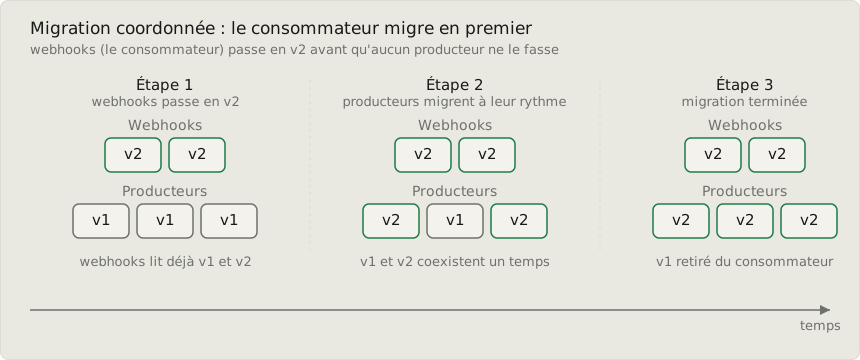
Dans le cas réel que j'ai rencontré, c'était ce qu'on avait fait. Tout simplement parce que nous avions peu de producteurs d'évènements (un seul gros monolithe) et qu'on pouvait déployer bien plus vite sur nos instances webhooks. Cependant, si on ne fait pas attention et qu'on finit par déployer du v3 (nouvel évènement) ou du v4 (breaking change) sur nos apps et qu'on n'a pas fini de déployer sur les webhooks, on va avoir des erreurs! Et si jamais on n'avait pas été capable de coordonner nos déploiements, il aurait été plus compliqué de gérer ça. C'est là que le forward compatible devient intéressant.
Forward Compatible
Le Forward Compatible, c'est l'idée d'être capable de lire des messages qui viennent du futur. Il y a deux types de changements: ceux qui sont backward compatible et ceux qui ont des breaking changes. Si demain on reçoit un évènement qui a toujours les champs que je connais et dont j'ai besoin, grâce à ma modélisation résiliente, je pourrai toujours les lire et les utiliser. Si on reprend le code Java d'exemple utilisé plus haut : le code écrit pour la v1, avant même de connaître l'existence de currency, n'a jamais eu besoin d'être modifié pour survivre à son arrivée en v2 — il ignore tout simplement ce qu'il ne lit pas. Ce n'est pas grave puisqu'en v1 des webhooks on ne pouvait pas deviner que ce champ existerait un jour! Donc faire du backward compatible nous permet déjà d'être Forward Compatible pour les évolutions mineures!
Pour ce qui est des nouveaux types d'évènements. Notre modélisation JSON faisant que peu importe le type de message, seule la map data est différente, on n'aura pas d'erreur de sérialisation. En revanche on sera incapable de lire le nouveau type de message. Pour éviter les erreurs, on doit router les types d'évènements et avoir un fallback sur les évènements inconnus:
    public void process(EventEnvelope envelope) {
        ProcessedEvent.Outcome outcome = switch (envelope.eventType()) {
            case ORDER_CREATED -> {
                handleOrderCreated(envelope);
                yield ProcessedEvent.Outcome.PROCESSED;
            }
            case UNKNOWN -> {
                log.warn("Ignoring event {} of unknown type (version {}) — nothing crashed", envelope.id(), envelope.version());
                yield ProcessedEvent.Outcome.IGNORED_UNKNOWN_TYPE;
            }
        };

        store.record(new ProcessedEvent(envelope.id(), envelope.eventType(), envelope.version(), outcome, Instant.now()));
    }
Mais alors, quid de la v4 avec un breaking change ? Eh bien pas le choix, si une des deux exceptions est levée (donc l'absence d'un champ obligatoire) on doit la traiter. Le plus simple est de log un warning indiquant qu'un message du futur est devenu "illisible". Dans le cas d'api REST on renvoie une 422 Unprocessable Entity, si on fait du message queue on nack le message pour qu'il soit rejoué plus tard. Je ne détaille pas la gestion de ces erreurs, notamment avec du message queue tel que Pub/Sub, ce n'est pas le propos de l'article.
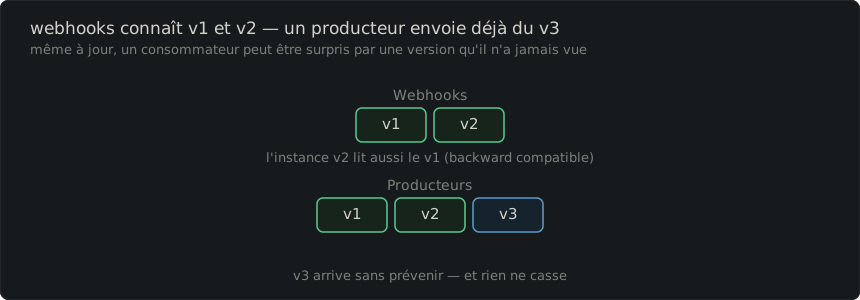
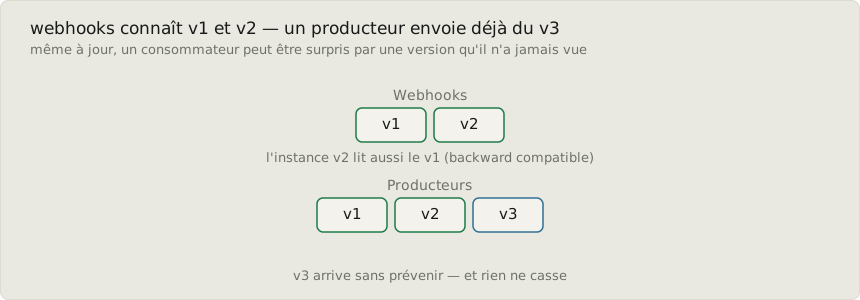
Ainsi on n'est plus obligé de coordonner les déploiements, nos webhooks v1 pourront recevoir des messages v1 et v2 sans erreurs. On pourra même recevoir du v3 (nouvel évènement inconnu) et log un warning. Pour la v4 on aura des logs de warning et des 422 (ou nack) le temps que le déploiement soit terminé.
Exemple de code avec le poc
Pour mieux comprendre et illustrer tout ça, j'ai fait générer par Claude Code un repo d'exemple, que j'ai bien sûr revu et corrigé. Vous pourrez le trouver ici : Yagni/forward-compatible-events
On y trouve deux modules, un par application Spring Boot. Un producer et un consumer d'évènements. On peut réaliser des appels REST sur le producer pour lui faire générer des évènements v1, v2, v3 ou v4. Ces évènements seront envoyés au consumer par une requête REST émise par le producer. Une ligne de log est censée être écrite pour chaque évènement reçu avec les informations qu'il contient.
Rentrons un peu dans le détail, du moins sur les parties qui nous intéressent. Pour la partie producer, il s'agit surtout de regarder les différents évènements envoyés. On les retrouve dans resources/events . On y retrouve la modélisation résiliente qu'on a évoquée plus haut :
{
  "version": "1",
  "eventType": "ORDER_CREATED",
  "id": "v1-order-1",
  "occurredAt": "2026-01-01T10:00:00Z",
  "data": {
    "orderId": "ord-1",
    "amount": 42.50
  }
}
{
  "version": "3",
  "eventType": "ORDER_REFUNDED",
  "id": "v3-order-1",
  "occurredAt": "2026-03-01T10:00:00Z",
  "data": {
    "orderId": "ord-3",
    "reason": "customer_request"
  }
}
On a donc bien un modèle commun et uniquement la map data qui diffère selon le eventType. Le champ version étant ici uniquement cosmétique. On pourrait, pour aller plus loin, utiliser cette version pour faire cohabiter plusieurs versions d'un même type d'évènement et avoir plusieurs méthodes différentes handleOrderCreated(...) et handleOrderCreatedV2(...).
Pour ce qui est du consumer, on a beaucoup plus de choses à regarder. Déjà commençons par la modélisation en Java de ces évènements:
consumer/model/EventType.javapublic enum EventType {
ORDER_CREATED,
@JsonEnumDefaultValue
UNKNOWN
}
@JsonIgnoreProperties(ignoreUnknown = true)
public record EventEnvelope(
        String version,
        EventType eventType,
        String id,
        Instant occurredAt,
        Map<String, Object> data
) {
}
On retrouve bien le EventEnvelope déjà vu avec le @JsonIgnoreProperties(ignoreUnknown = true) qui permet de ne pas avoir d'erreur en cas de champ inconnu. Mais on a cette fois aussi une petite subtilité nouvelle dans EventType avec le @JsonEnumDefaultValue qui mettra par défaut à UNKNOWN toute valeur inconnue de l'enum. On évite donc l'erreur lors des nouveaux types d'évènements que l'enum ne connaitrait pas.
Pour ce qui est du controller REST rien d'exceptionnel, on délègue la gestion de l'évènement à un service. On ne traite ici que la partie REST:
consumer/EventsController.java @PostMapping
public ResponseEntity<Void> receive(@RequestBody EventEnvelope envelope) {
processingService.process(envelope);
return ResponseEntity.accepted().build();
}
Le service en question est lui plus intéressant. On a déjà vu quelques extraits, mais voici sa version complète (rien de neuf ici, c'est juste l'assemblage de ce qu'on a déjà vu) :
consumer/EventProcessingService.java@Service
public class EventProcessingService {
private static final Logger log = LoggerFactory.getLogger(EventProcessingService.class);
private final InMemoryEventStore store;
public EventProcessingService(InMemoryEventStore store) {
this.store = store;
}
public void process(EventEnvelope envelope) {
ProcessedEvent.Outcome outcome = switch (envelope.eventType()) {
case ORDER_CREATED -> {
handleOrderCreated(envelope);
yield ProcessedEvent.Outcome.PROCESSED;
}
case UNKNOWN -> {
// A type this consumer has never heard of. Forward-compatible
// means "safely ignored today", not "silently dropped forever" —
// it's still recorded, just not acted upon.
log.warn("Ignoring event {} of unknown type (version {}) — nothing crashed", envelope.id(), envelope.version());
yield ProcessedEvent.Outcome.IGNORED_UNKNOWN_TYPE;
}
};
store.record(new ProcessedEvent(envelope.id(), envelope.eventType(), envelope.version(), outcome, Instant.now()));
}
private void handleOrderCreated(EventEnvelope envelope) {
Object orderId = envelope.data().get("orderId");
if (orderId == null) {
throw new MissingRequiredFieldException("orderId", envelope.id(), envelope.eventType().name());
}
Object amount = envelope.data().get("amount");
if (amount == null) {
throw new MissingRequiredFieldException("amount", envelope.id(), envelope.eventType().name());
}
// v2 field: absent on v1 events, so it's read with a default rather
// than required — that's what makes it safe to adopt before every
// producer (and every past event) is on v2.
Object currency = envelope.data().getOrDefault("currency", "EUR");
log.info("Order {} created, amount={} {}", orderId, amount, currency);
}
}
Je l'ai déjà expliqué en grande partie mais on y retrouve les points importants:
- Gestion des évènements inconnus par un warning mais pas d'exception!
- Gestion des breaking changes par un 422.
- Backward Compatibility en n'ayant des erreurs uniquement lorsqu'il manque un champ obligatoire dans les données.
- Utilisation de valeur par défaut si besoin en cas d'absence de champ optionnel (v2).
Le reste de l'application c'est du détail qui n'apporte rien à l'article ici. On peut tester le poc en démarrant les deux applications et en envoyant des curls sur le producer pour tester les différents scénarios. Pour les scénarios v1 et v2 on voit bien ces lignes dans les logs du consumer:
Order ord-1 created, amount=42.5 EUR
Order ord-2 created, amount=19.9 USD
Pour la v3 on obtient bien le warning:
Ignoring event v3-order-1 of unknown type (version 3) — nothing crashed
Enfin pour la v4 on a ceci:
$ curl -X POST http://localhost:8081/publish/v4-breaking-rename
Event v4-order-1 (type ORDER_CREATED) is missing required field 'orderId' — this is a breaking change, not a forward-compatible one
L'application consumer est dans une version équivalente à ce qu'on avait décrit pour la v2:
- rétro compatible v1
- gère le v2
- warning sur du v3
- 422 sur du v4 breaking change
Bonnes pratiques
- Séparer l'enveloppe des données métiers. La map
datadans l'exemple -> un champ additionnel ne casse rien. On peut également gérer plusieurs types d'évènements sans avoir à les connaitre à l'avance. - Ignorer les champs inconnus, sinon ça ne marche pas. Comme avec le
@JsonIgnoreProperties(ignoreUnknown = true)de Jackson. - Prévoir un type/enum ouvert avec un fallback explicite. Ici on a utilisé le
@JsonEnumDefaultValue + UNKNOWN. - Lire les champs optionnels en étant défensif pour les nouvelles versions. Voire même utiliser des valeurs par défaut si ça a du sens.
- Ne rendre les champs obligatoires que s'ils le sont vraiment, ni plus ni moins. Ça ne rendra pas un vrai renommage comme la v4 moins breaking, mais ça évite d'en créer d'autres inutilement, en exigeant des champs dont le code n'a en réalité pas besoin.
- Distinguer les cas "je ne sais pas traiter ça" de "il me manque une donnée vitale". Le premier peut être retenté plus tard : l'évènement est peut-être inconnu simplement parce que le déploiement du support de cette version est encore en cours, pas parce qu'il ne le sera jamais. Le second doit échouer et informer immédiatement (ici une 422).
- Ne pas utiliser la Forward Compatibility pour faire n'importe quoi. On évitera autant que possible de faire des breaking changes!
- Un déploiement rapide du consommateur réduit la fenêtre de risque, il ne la supprime pas.
conclusion
On a donc vu ici ce qu'était la Backward Compatibility, le code nouveau qui lit de l'ancien. On a vu aussi ce qu'était la Forward Compatibility, l'ancien qui survit au nouveau. On a vu également que faire du Backward permet facilement le Forward. Il en est la suite logique, mais pas forcément nécessaire, après tout YAGNI! Enfin on a vu que ce n'était pas un prétexte pour faire n'importe quoi, ainsi que plein d'autres bonnes pratiques. N'hésitez pas à cloner, tester ou modifier le POC si vous voulez : Yagni/forward-compatible-events